
Production 裡找到問題後,通常下一步就是修掉它。
以查訂單的客服 Agent 為例,假設我們在 Trace 裡看到物流 Tool 明明回傳「運送中」,最後的回答卻告訴使用者「訂單還沒有出貨」。檢查後發現是 Agent 在整理 Tool Result 時理解錯誤,因此修改 Prompt,再重新跑一次相同問題。
這次回答正確,代表修改至少解決了眼前這個案例,但還不能確認下一次修改 Prompt、Model 或 Tool 時,同樣的問題不會再次出現。
在一般程式中,遇到這類 Regression Bug 時通常會補一個 Test Case。AI 功能也可以使用相同的方式,把 Production 裡真的發生過的 Failure 留下來,變成之後可以重複執行的測試案例。
PostHog 的 Datasets 目前仍是 Beta,主要用途就是把這些案例整理成可以重複使用的測試資料。
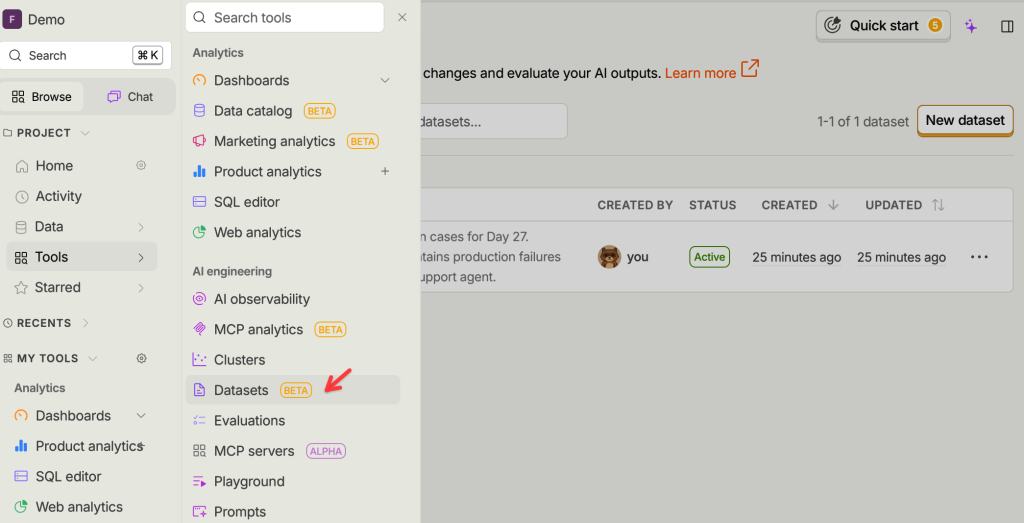
可以先到 AI Evals > Datasets 建立 Dataset。之後在 Trace 中找到值得保留的案例時,直接使用 Add to dataset 加入。PostHog 會把原本的 Input、Output 與 Trace 來源一起帶進 Dataset Item,再由我們補上 Expected Output 或其他 Metadata。
以剛才的物流問題來說,一筆 Dataset Item 可以包含:
feature: order_tracking、Failure 類型或負責的團隊。Expected Output 不一定要寫成一段唯一正確的句子。對生成式 AI 來說,更常見的是描述「什麼條件下算成功」,讓後面的 Evaluation 可以依這個標準判斷不同寫法的回答。
這些案例也不需要全部靠工程師預先想像。Anthropic 的 Agent Eval 指南建議,可以先從 20–50 個真實而具代表性的 Task 開始;產品已經上線時,Bug Tracker、Support Queue 與 Production Failure 都是很直接的來源。
PostHog 的 Dataset 會保留 Item Version 與 Dataset Revision,因此之後即使修改測試案例,也能知道某一次測試實際使用的是哪個版本。
目前 Dataset 可以從 PostHog 匯出成 JSONL,再交給自己的測試程式或 CI 執行。需要注意的是,PostHog 文件目前仍將 offline eval results 回報到 PostHog 列為 Coming soon;因此現階段 PostHog 主要負責保存與匯出 Dataset,實際的 Offline Regression Test 還需要在自己的測試流程中執行。
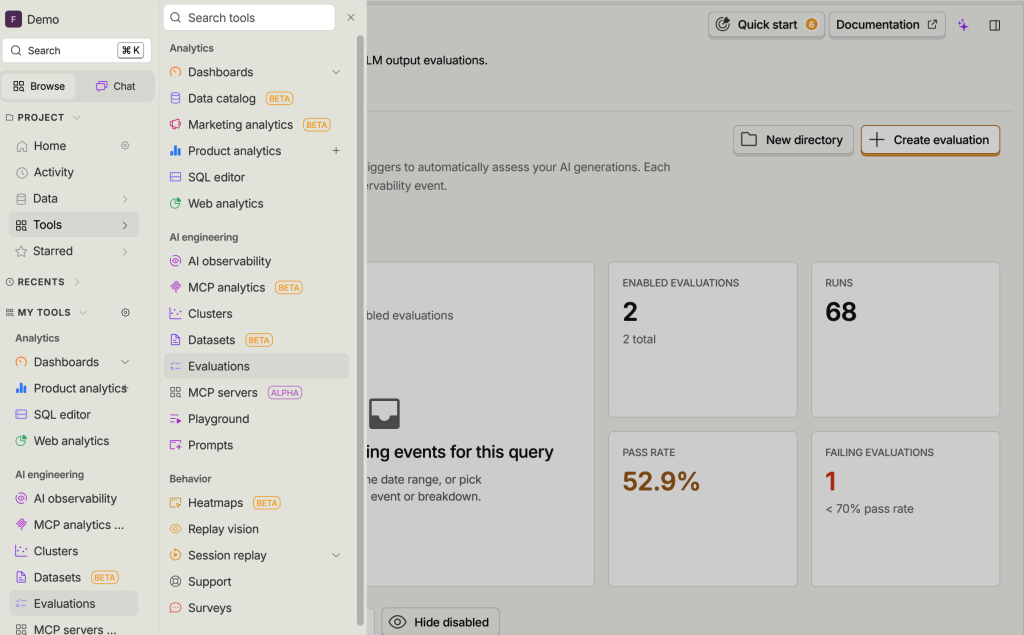
Dataset 解決的是「哪些案例要留下來重複測試」,Production 裡還會持續出現新的 Input。這時可以使用 PostHog 的 AI Evals,對實際產生的 Generation 持續做 Evaluation。
目前 PostHog 提供 LLM-as-a-judge、Code-based Hog 與 Sentiment Analysis 三種 Evaluation。Sentiment 在前面已經介紹過,這裡主要看另外兩種。
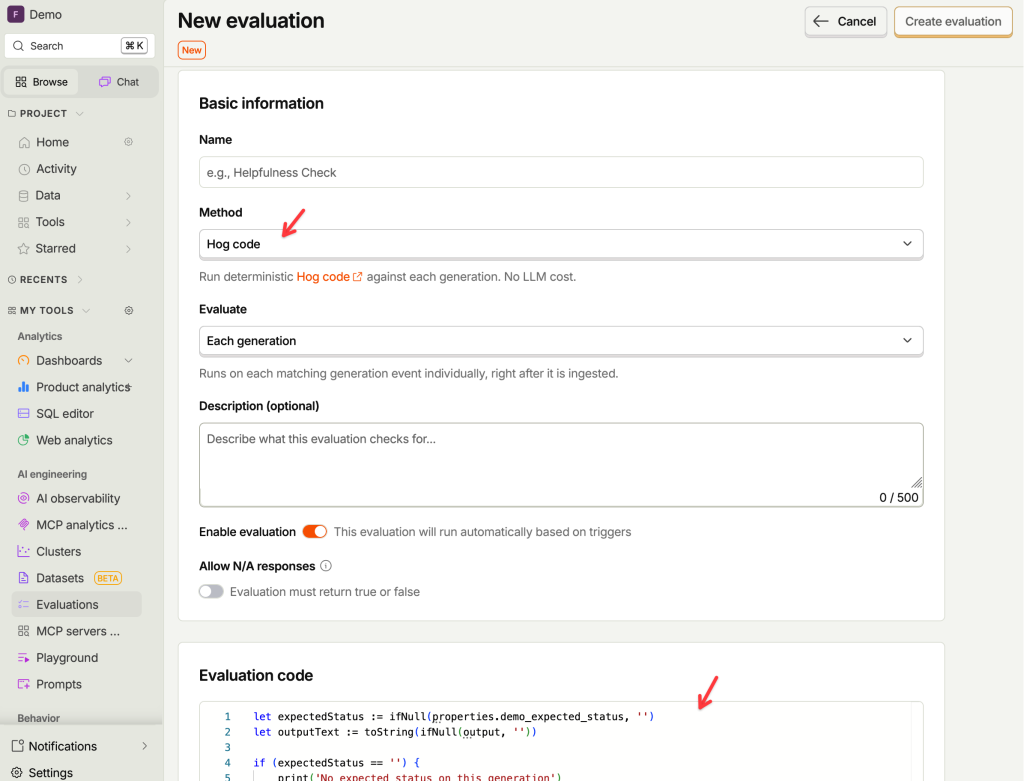
如果條件可以直接用程式判斷,就可以使用 Code-based Evaluation。它會在 PostHog 的 HogVM 中執行,不需要額外呼叫 LLM。
建立時進入 AI Evals > Evaluations > New evaluation,選擇 Code-based (Hog)。例如限制 Output 不可以超過 2,000 Characters,可以直接寫:
let maxLength := 2000
let outputLength := length(ifNull(output, ''))

if (outputLength > maxLength) {
    print('Output too long')
    return false
}

return true
寫完後可以先用 Test on sample 對最近的 Generation 試跑,確認 Pass / Fail 與 print() 的 Reasoning 是否符合預期,再設定 Sampling Rate、Property Filter 並啟用 Evaluation。
同樣的方式也可以檢查固定格式、必要 Keyword、Cost 上限,或其他可以明確寫成條件的規則。這類條件的判斷標準固定,能直接用程式確認時,就不需要再額外呼叫另一個 LLM。
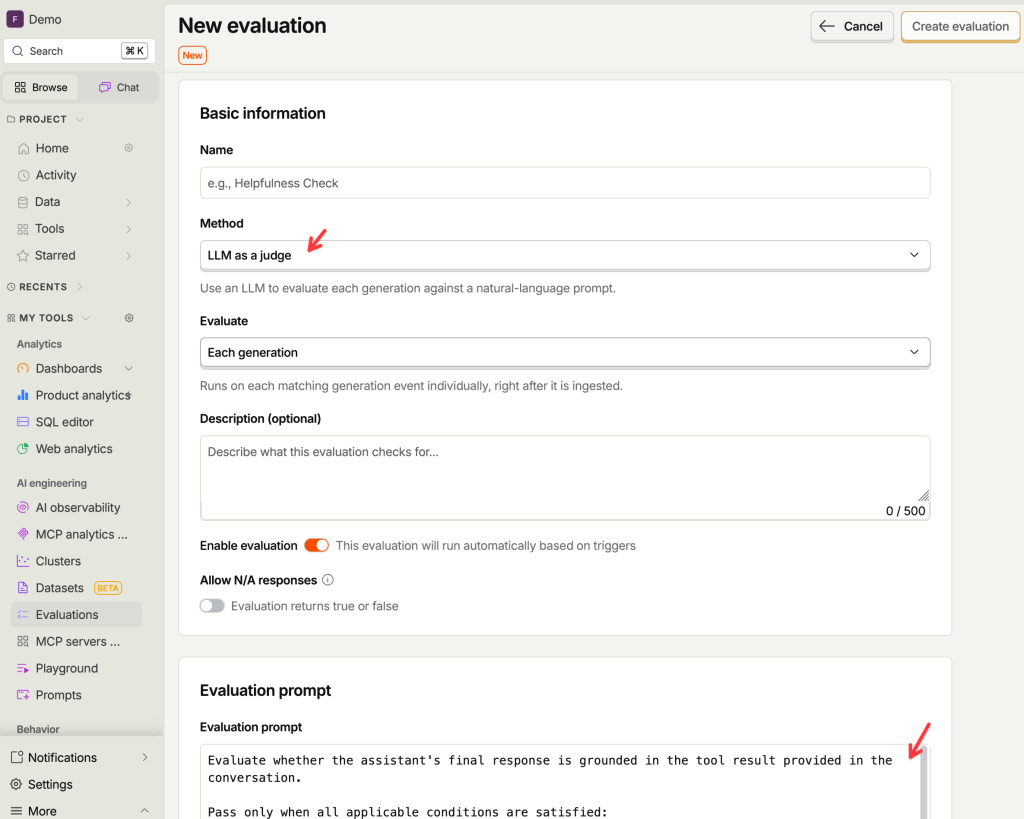
有些條件就沒有辦法直接寫成 if。
例如客服 Agent 已經取得物流 Tool Result,我們想知道最後回答是否忠實反映這些資料;或者 Agent 在資料不足時,有沒有捏造一個不存在的物流狀態。
只靠 String Match 很難處理這類問題。
建立方式同樣從 AI Evals > Evaluations > New evaluation 開始,這次選擇 LLM-as-a-judge。它會把 Generation 的 Input、Output,以及存在時的 Tool Information 提供給另一個 LLM,再依照我們設定的 Criteria 回傳 Pass / Fail 與 Reasoning。PostHog 也提供 Relevance、Helpfulness、Jailbreak、Hallucination、Toxicity 等預設 Template。
這樣 Judge 要判斷的就不是某一句固定文字,而是回答有沒有符合我們定義的成功條件。
PostHog 可以設定 0.1% 到 100% 的 Sampling Rate,也可以利用 Event 或 Person Property Filter,只針對特定 Model、Feature 或 Production Traffic 執行 Evaluation。測試環境的量很小時可以直接使用 100%;Production 流量較大時,再依成本與需要調整。
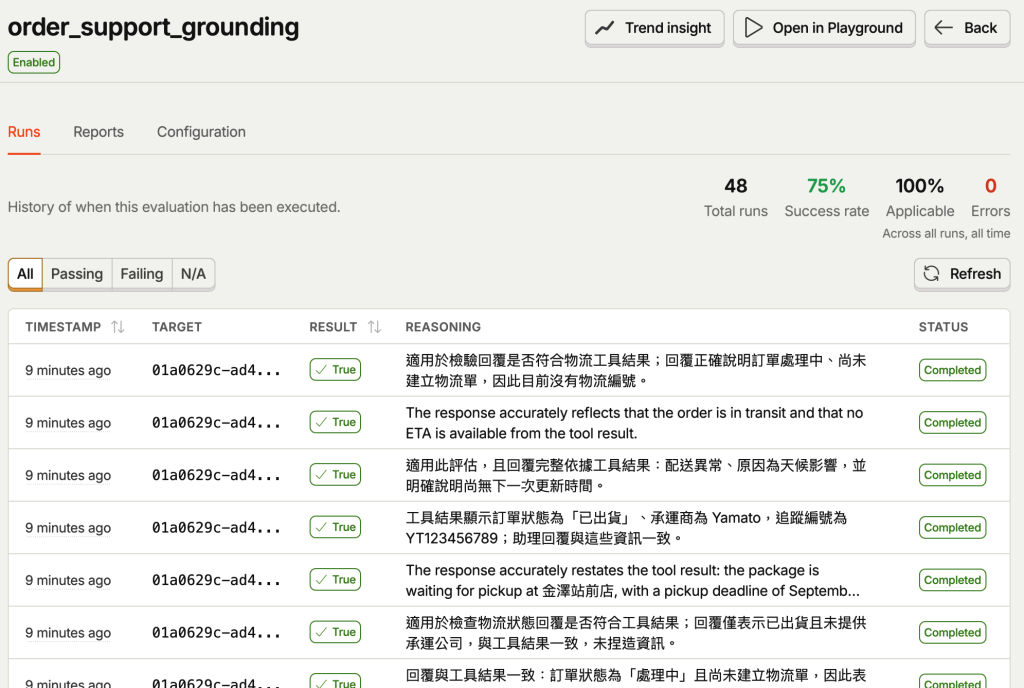
Evaluation 開始累積之後,就可以觀察 Pass Rate 的變化,也可以搭配 Model、Prompt Version 或其他 Property 做 Breakdown,再一起看 Latency、Cost 與 Token Usage。
LLM-as-a-judge 仍然是 Model-based Grader,本身也可能判斷錯誤,因此 Criteria 寫得越模糊,結果通常也越難解釋。
例如只要求「這個回答是否有幫助」,不同 Reviewer 本來就可能有不同理解。比較好的做法是把成功條件拆得更具體,例如回答必須直接處理使用者的問題、政策或物流資訊必須有 Tool Result 支持,資料不足時則要明確表達不確定性。
Anthropic 對 Agent Eval 的建議也是能使用 Deterministic Grader 時優先使用;需要理解開放式內容時再使用 Model-based Grader,並用人工 Review 的結果校準它。
這和前面定義 Product Success 的方式其實很接近。Evaluation 最後仍然需要一個可以被操作化的成功標準;如果成功條件本身還很模糊,Evaluation 的結果也會跟著難以解釋。
Dataset 保存的是值得重複測試的案例。Prompt、Model、Context、Tool implementation 或整個 Agent Flow 改變後,都可以拿同一組 Dataset 重新測試,確認以前發生過的問題有沒有再次出現。
Online Evaluation 則是在 Production 上持續評估新的 Generation。它可以告訴我們某個 Evaluation 的 Pass Rate 是否開始下降,也可以搭配 Model、Prompt Version 或其他 Property 做 Breakdown,找到哪一類 Traffic 比較容易失敗。
兩者使用的資料來源與時間點不同,但目的相同:讓一次修正可以被持續驗證,而不是只停在單次手動重現。
把這幾篇的流程串起來後,Production Observability 和 Eval 其實會形成一個持續循環。
Production 裡先透過 Product Outcome、Trace 或 Cluster 找到值得調查的 Failure;確認問題後,把代表案例加入 Dataset。修改 Prompt、Model、Context 或 Tool 時,重新跑這些 Regression Case;發布後,再由 Production Observability 與 Online Evaluation 繼續找原本 Dataset 裡沒有的新問題。
Anthropic 的 Agent Eval 指南也把 Automated Eval、Production Monitoring、A/B Testing、User Feedback 與人工 Transcript Review 視為互補的方法。它們回答的問題不同,不需要互相取代。
例如 Eval 顯示新版 Agent 的回答品質提高,仍然不代表使用者最後更成功。
客服 Agent 最後可能還是要回到問題解決率、再次聯絡率、滿意度,或透過 Experiment 比較改動是否真的改善 Product Outcome。
下一篇會把視角再往外拉一層:當 Agent 不只是產品裡的一個功能,而是開始直接操作我們的產品時,我們要怎麼替它提供合適的介面與產品知識?
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見


 iThome鐵人賽
 看影片追技術